Headless CMS dla sklepu internetowego: kiedy architektura jest uzasadniona

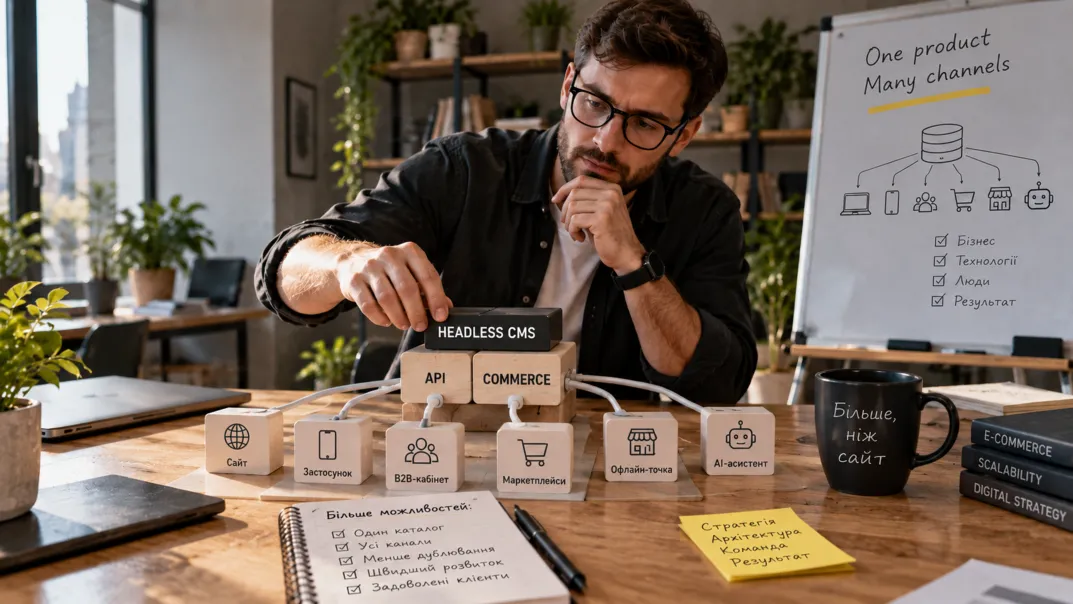
Współczesny sklep internetowy rzadko żyje wyłącznie na stronie. Ten sam katalog pokazują aplikacja mobilna, panel B2B dla dealerów, marketplace’y, tablet konsultanta w sklepie stacjonarnym, a teraz także asystent AI. Gdy każdy kanał trzyma własną kopię opisów i parametrów, rozbieżności pojawiają się już po kilku tygodniach: na stronie zaktualizowano skład produktu, a w aplikacji został stary; w panelu B2B cena jest jedna, na marketplace inna.
Headless CMS dla sklepu internetowego rozwiązuje ten problem radykalnie: system zarządzania treścią nie odpowiada już za wygląd strony. Przechowuje treść i logikę biznesową, a dowolny interfejs pobiera potrzebne dane przez API. Wokół tego podejścia narosło wiele mitów, więc od nich zaczniemy.
Cztery mity o headless
Mit 1: headless jest zawsze szybszy
Osobny frontend daje kontrolę nad szybkością, ale jej nie gwarantuje. Ciężki bundle JavaScript albo wolne API z łatwością zniwelują przewagę. Szybkość daje praca z zasobami krytycznymi i cache, a nie sama architektura.
Mit 2: headless szkodzi SEO
Samo podejście jest neutralne. Problemy pojawiają się, gdy kluczowe strony renderują się wyłącznie w przeglądarce. Jeśli kategorie i produkty serwuje serwer, mają własne adresy, metadane i zwykłe linki, wyszukiwarka widzi je tak samo jak w klasycznym CMS.
Mit 3: headless jest potrzebny każdemu
Sklepowi z jednym kanałem sprzedaży i standardowym katalogiem zwykle dodaje tylko kosztów. Prosty test: jeśli nie potrafisz wskazać co najmniej dwóch kanałów, które potrzebują tej samej treści, oraz zadania biznesowego blokowanego dziś przez CMS, korzyści nie będzie.
Mit 4: headless i headless commerce to to samo
Headless CMS zarządza treścią: stronami, banerami, opisami, artykułami. Headless commerce obejmuje dodatkowo produkty, ceny, koszyk, kody rabatowe i zamówienia. Sklep zwykle potrzebuje obu, dlatego architekturę planuje się całościowo.
Co naprawdę znaczy „odciąć głowę”
W klasycznym CMS panel administracyjny, szablony i renderowanie działają jako całość: redaktor klika „Zapisz”, a system sam składa stronę. W headless interfejs jest oddzielony: CMS i backend commerce udostępniają dane przez API, a strona, aplikacja czy panel partnera to osobne programy, które te dane pobierają i pokazują po swojemu.
Drupal, na którym działa wiele projektów e-commerce, ma moduł JSON:API bezpośrednio w rdzeniu, więc można go używać jako backendu dla osobnego frontendu bez dodatkowych nakładek.
Trzy warianty architektury, a nie dwa
Wybór rzadko jest binarny. W praktyce sklep wybiera między trzema stanami.
| Wariant | Kiedy pasuje | Zaleta | Ryzyko |
|---|---|---|---|
| Klasyczny monolit | Jeden kanał, standardowy katalog | Najtaniej i najszybciej | Trudno dodać nowe kanały |
| Częściowo oddzielony frontend | Szybki UX potrzebny na części stron | Można iść etapami | Dwa modele renderowania naraz |
| Pełny headless | Kilka witryn, złożone integracje | Niezależny rozwój kanałów | Najwyższy koszt i wymagania wobec zespołu |
Wariant środkowy bywa niedoceniany, choć to właśnie on daje większość korzyści bez pełnej przebudowy platformy.
Kiedy headless naprawdę się zwraca
Najsilniejszy argument to kilka kanałów z jednym katalogiem: menedżer zmienia parametr raz, a aktualizuje się on wszędzie. Dla sieci z kilkoma markami lub krajami oznacza to dziesiątki godzin oszczędności miesięcznie.
Drugi to niezależny rozwój witryny: zespół frontendu przerabia koszyk czy kartę produktu, nie dotykając obsługi zamówień. Trzeci to złożone integracje z PIM, ERP, CRM, wyszukiwaniem i usługami AI. Jest tu pułapka: API trzeba projektować jak osobny produkt — z wersjami, uprawnieniami, logami i limitami zapytań.
Czwarty scenariusz to potrzeba szczególnego doświadczenia mobilnego, na przykład PWA z trybem offline i instalacją na urządzeniu.
Co zmienia się dla zespołu treści
Ten aspekt bywa niedoceniany najczęściej. W zwykłym CMS redaktor widzi stronę niemal taką, jaką zobaczy klient. W headless treść jest przechowywana oddzielnie od projektu, więc podgląd, wersje robocze, akceptacje i publikację do kilku kanałów trzeba zaprojektować osobno.
Jeszcze przed rozwojem warto ustalić, z jakich komponentów redaktor będzie składał strony, jak zadziała podgląd, kto akceptuje zmiany, jak wygląda lokalizacja i co się stanie przy zmianie struktury API. Inaczej technicznie doskonały system okaże się niewygodny dla ludzi, którzy codziennie wypełniają sklep treścią.
SEO i bezpieczeństwo w projekcie headless
Wyszukiwarka potrzebuje pełnowartościowych stron: własnego adresu, poprawnego kodu statusu, title, description, canonical, danych strukturalnych i zwykłych linków HTML. Kluczowe strony sklepu wymagają renderowania po stronie serwera lub prerenderingu — Google wykonuje JavaScript z opóźnieniem, a inne roboty i usługi AI mogą nie wykonywać go wcale. Zasady indeksowania filtrów projektuje się osobno: jak to zrobić, opisaliśmy w artykule o nawigacji fasetowej. Jeśli wdrożeniu towarzyszy zmiana adresów, obowiązują wszystkie zasady z naszego planu redesignu bez utraty SEO.
Oddzielenie frontendu nie czyni systemu bezpieczniejszym — przeciwnie, dodaje punkt wejścia. Publiczna witryna może wyłącznie czytać dozwolone dane katalogu, operacje na profilu, koszyku czy zamówieniu weryfikują użytkownika, a klucze dostępu nigdy nie trafiają do kodu frontendu.
Ile to kosztuje
Budżet nie ogranicza się do licencji czy konfiguracji CMS. Na całkowity koszt posiadania składają się osobny frontend i jego hosting, API oraz warstwa integracji, podgląd dla redaktorów, wyszukiwanie i cache, autoryzacja, monitoring, środowiska testowe, migracja danych i zachowanie SEO. Utrzymywać trzeba nie jeden system, lecz kilka.
Na starcie projekt headless jest zwykle istotnie droższy od klasycznego. Zwraca się tam, gdzie szybkość uruchamiania nowych kanałów i funkcji daje więcej, niż kosztuje złożoność. Logika rachunku przypomina porównanie low-code i custom development: liczyć trzeba na dwa-trzy lata, a nie na wdrożenie.
Plan pierwszych 90 dni
Pierwszy miesiąc to badanie: lista kanałów i scenariuszy na dwa-trzy lata, spisanie ograniczeń obecnego CMS, audyt katalogu i integracji. Drugi to prototyp jednego krytycznego scenariusza, na przykład wspólnej karty produktu dla strony i aplikacji, na realnych danych i z pomiarem szybkości.
Trzeci miesiąc to decyzja i plan: porównanie trzech wariantów architektury pod kątem kosztu, ryzyka i gotowości zespołu, wybór modelu renderowania, zasady SEO oraz lista etapów. Dopiero potem zaczyna się pełny rozwój witryny.
Często zadawane pytania
Czy headless nadaje się dla małego sklepu?
Najczęściej nie. Przy jednym kanale sprzedaży klasyczny CMS da ten sam efekt taniej i szybciej.
Czy można przejść na headless stopniowo?
Tak i jest to najbezpieczniejsza droga. Najpierw przez API zasila się jeden nowy kanał, a strona pozostaje na klasycznym CMS. Potem witryny przenosi się etapami.
Czy trzeba zmieniać CMS?
Nie. Wiele systemów, w tym Drupal, może działać jako backend headless bez wymiany platformy — przez JSON:API.
Ile trwa wdrożenie?
Prototyp jednego scenariusza to kilka tygodni. Pełne uruchomienie sklepu z integracjami trwa kilka miesięcy.
Headless CMS jest uzasadniony, gdy niezależność kanałów i tempo rozwoju są ważniejsze niż prostota monolitu. Zespół GL.ua może przeprowadzić audyt architektury i ocenić, czy potrzebujesz pełnego oddzielenia frontendu, czy taniej rozwiązać zadanie w obecnej platformie. Zacząć można od konsultacji dotyczącej tworzenia strony.
Tylko jeden krok do Twojej idealnej strony internetowej