Як підготувати каталог товарів для AI, SEO та маркетплейсів

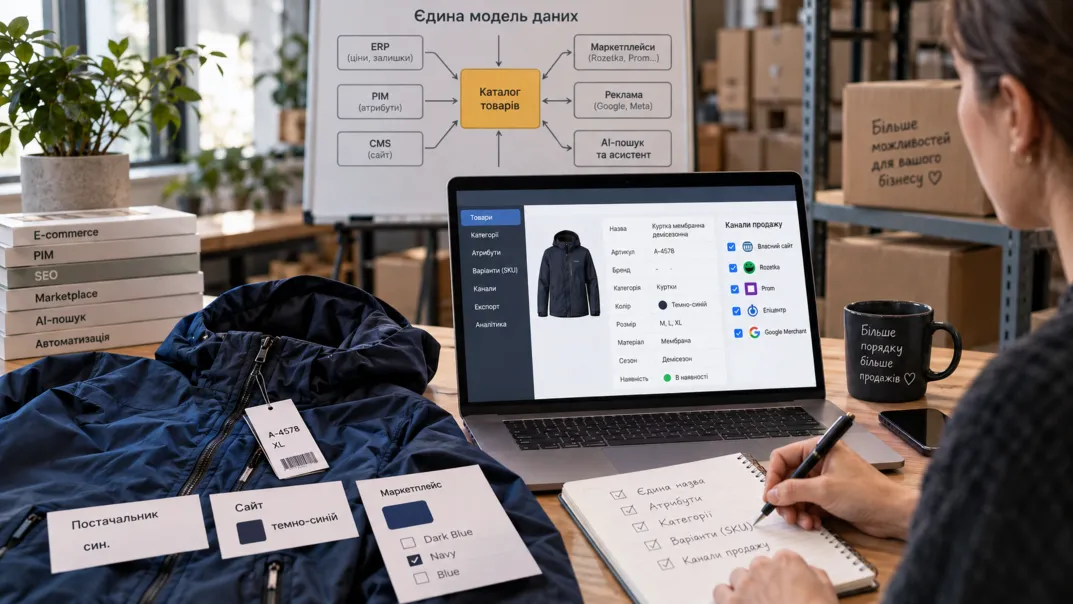
У таблиці постачальника колір записаний як «син.», на сайті — «темно-синій», а маркетплейс вимагає значення зі свого довідника. Один товар має три різні назви, неповні характеристики й два артикули. Поки асортимент невеликий, менеджери виправляють це вручну. Але з ростом каталогу ручні правки перестають встигати, і помилки б'ють по пошуку, рекламі, залишках і поверненнях.
Сильна структура каталогу товарів — це не перелік карток, а модель даних. Вона має однаково добре живити сайт і фільтри, AI-пошук, SEO, рекламні фіди та зовнішні канали продажу. Нижче — п'ять рівнів зрілості каталогу: подивіться, на якому ви зараз, і що дає перехід на наступний.
Рівень 0. Дані живуть у файлах постачальників
Ознаки: назви й характеристики копіюють із прайсів, колір і матеріал записані вільним текстом, той самий товар у різних категоріях виглядає по-різному. Фільтри або не працюють, або показують дивні значення.
Що дає перехід далі: щойно з'являються довідники значень, фільтри починають працювати коректно, а менеджери перестають витрачати години на пошук дублікатів.
Рівень 1. Є джерело правди для кожного поля
Перше системне рішення — визначити, де зберігається головна версія кожного типу даних. Найпоширеніша схема: ціни та залишки живуть в ERP, описи й атрибути — у PIM або CMS, зображення — у сховищі медіа, клієнтські дані — у CRM. Маркетплейс при цьому лише канал публікації, а не місце редагування товару.
| Тип даних | Джерело правди | Хто відповідає | Частота оновлення |
|---|---|---|---|
| Ціна, залишок | ERP або облікова система | Фінанси, закупівлі | Кілька разів на день |
| Назва, опис, атрибути | PIM або CMS | Контент-менеджер | За потреби |
| Фото, відео | Медіасховище | Контент-менеджер | За потреби |
| Категорії каналів | Таблиця зіставлення | Менеджер маркетплейсів | Щомісяця |
Принцип простий: для кожного поля одне місце зміни й одна відповідальна людина. Коли ціну можна змінити одночасно в обліку, на сайті й у кабінеті маркетплейсу, розбіжності неминучі.
Рівень 2. Атрибути стали довідниками
Атрибут — це не просто поле, а назва, тип даних і перелік допустимих значень. Замість вільного тексту, де колір записаний як «чорний», «black» і «чорн.», потрібен нормалізований довідник.
Корисно розділяти атрибути товарів за призначенням: загальні для всіх (бренд, країна, гарантія), специфічні для категорії (діагональ, матеріал, потужність), варіативні (колір, розмір), операційні (вага й габарити для доставки) і канальні, потрібні лише конкретному маркетплейсу. Для кожної категорії зафіксуйте обов'язкові поля — і забороніть автоматичну публікацію товару, у якого вони порожні.
Ефект видно одразу: фільтри перестають дублювати значення, а частка товарів, відхилених каналами, падає.
Рівень 3. Продукт і варіанти розділені
Модель даних має розрізняти продукт і його варіанти. Одна модель кросівок має спільну назву, опис і фото, але кожне поєднання розміру й кольору — окремий SKU зі своїм залишком і штрихкодом.
Якщо цю різницю не закласти від початку, магазин або плодить дублікати карток, або не може показати наявність конкретного розміру. Для варіантів заздалегідь визначають ідентифікатори, зв'язок із батьківським продуктом, набір варіативних атрибутів, правила формування адрес і canonical. Для маркетплейсів і Google Merchant Center знадобляться коректні штрихкоди GTIN: без них частина каналів відхилить товар або покаже його гірше.
Рівень 4. Каталог розуміють пошук і AI
AI-пошук і асистенти використовують не лише назву. Їм потрібні характеристики, призначення, сумісність і обмеження. Коли покупець питає «чи підійде цей чохол до мого телефону», відповідь можлива лише тоді, коли сумісність записана в даних, а не захована в тексті опису.
Найкраще працюють короткий опис без рекламних штампів, таблиця характеристик, сценарії використання, перелік сумісних товарів і короткий FAQ у картці. Наявність і терміни доставки мають підтягуватися з актуального джерела, а не копіюватися в текст. І правило, яке рятує від скарг: модель не повинна вигадувати відсутній параметр — якщо даних немає, система має уточнити запит. Детальніше — у матеріалах про AI-пошук товарів і ШІ-асистента для інтернет-магазину.
Категорії, які збігаються з попитом
Категорії будують із позиції покупця, а не складу. Якщо на складі товари розкладені за постачальниками, а людина шукає «все для кемпінгу», дерево має відповідати другій логіці.
Хороша таксономія має зрозумілі назви без внутрішнього жаргону, мінімум рівнів вкладеності й стабільні адреси, які не змінюються з кожною реорганізацією. Google радить будувати доступний ланцюжок посилань від меню до категорій і товарів: товар, до якого можна дістатися лише через внутрішній пошук, робот може так і не знайти. Які саме категорії створювати, підкаже аналіз попиту — про нього ми писали в статті про частотність ключових слів.
SEO каталогу
Каталог має унікальні сторінки категорій і товарів, керовані метадані, canonical, XML sitemap і структуровані дані Product. Шаблони title і description для тисяч карток — нормальна практика, але для пріоритетних сторінок лишають ручне редагування. Опис категорії повинен допомагати вибору, а не повторювати ключове слово. Окремо проєктують правила індексації фільтрів — про це в статті про фасетну навігацію.
Експорт на маркетплейси
Rozetka, Prom, Epicentr чи Allo мають власні дерева категорій, обов'язкові поля й вимоги до фото та назв. Тому між внутрішньою моделлю та кожним каналом потрібне зіставлення — mapping. Без нього менеджери щоразу заповнюють картки вручну, а помилки імпорту накопичуються непомітно.
Перед відправленням фіду варто автоматично перевіряти обов'язкові атрибути, формат ціни та валюти, наявність, якість зображень, довжину назв і відповідність категорії. Не менш важливо повертати помилки імпорту відповідальному менеджеру, а не лишати їх у кабінеті маркетплейсу, куди ніхто не заглядає.
Метрики якості каталогу
Якість даних вимірюють так само, як продажі. Найпоказовіші метрики:
- заповненість обов'язкових атрибутів по категоріях;
- кількість дублікатів SKU і товарів без категорії;
- частка помилок під час експорту в канали;
- частка нульових запитів у внутрішньому пошуку;
- розбіжності цін і залишків між системами.
Коли ці цифри видно на дашборді, покращення каталогу перестає бути разовою акцією й стає звичайним процесом.
Процес оновлення без ручних правок
Найстійкіша схема виглядає так: постачальник або менеджер додає дані, система нормалізує значення за довідниками, валідація перевіряє обов'язкові поля, відповідальна людина погоджує контент, і лише потім дані публікуються в усі канали. Помилки повертаються власнику, а кожна зміна журналюється — щоб можна було зрозуміти, хто і коли змінив ціну чи характеристику.
Часті запитання
Чи потрібна PIM-система невеликому магазину?
Якщо товарів до кількох тисяч і каналів один-два, вистачає добре налаштованої CMS із довідниками атрибутів. PIM стає виправданою при десятках тисяч SKU, кількох мовах і багатьох каналах.
З чого почати впорядкування каталогу?
З аудиту: які атрибути заповнені, де дублікати, які категорії приносять найбільше продажів. Починайте з найприбутковіших категорій — ефект буде помітний найшвидше.
Скільки часу займає перехід на наступний рівень?
Наведення ладу в атрибутах однієї великої категорії зазвичай займає кілька тижнів. Повна перебудова моделі даних із інтеграціями — кілька місяців, і її розбивають на етапи.
Як каталог впливає на AI-пошук?
Напряму. AI знаходить лише те, що описано в даних. Чим повніші й структурованіші атрибути, тим точніші відповіді та рекомендації.
Команда GL.ua може спроєктувати модель каталогу, інтегрувати PIM і ERP із сайтом і підготувати дані для AI-пошуку, SEO та маркетплейсів. Чим раніше зафіксовані стандарти, тим менше ручних виправлень після масштабування. Почати можна з SEO-аудиту чинного каталогу.
Всього один крок до вашого бездоганного сайту